 lefteros
29 Σεπτεμβρίου 2026 / Lefteris Iliadis / SomniusX
Ένα δικό μου μοντέλο στο Hugging Face: RecMeets' Laya
29 Σεπτεμβρίου 2026
Το somniusx/recmeets-laya-words βρίσκει ποιες λέξεις μιας απομαγνητοφώνησης ακούστηκαν λάθος, στα ελληνικά και στα αγγλικά. Εκπαιδευμένο στον υπολογιστή μου, ανοιχτό για όποιον το χρειάζεται.
Δημοσίευσα στο Hugging Face το πρώτο μοντέλο που εκπαίδευσα για το RecMeets: το somniusx/recmeets-laya-words. Κάνει ένα πράγμα και το κάνει καλά: διαβάζει μια λέξη μέσα στην πρότασή της, όπως την έγραψε μια μηχανή αναγνώρισης ομιλίας, και λέει πόσο πιθανό είναι να ακούστηκε λάθος. Στα ελληνικά και στα αγγλικά.
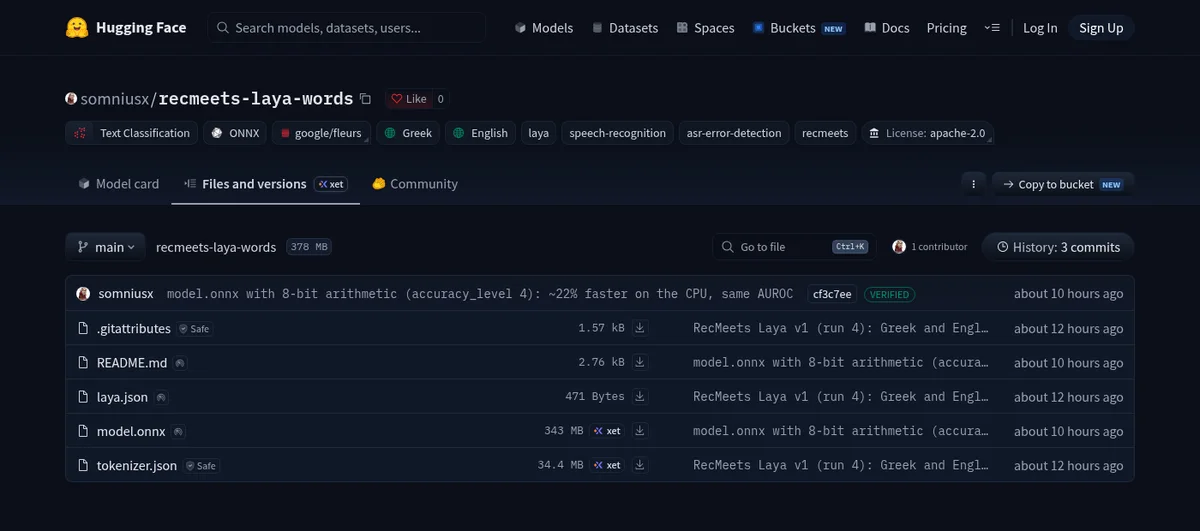 Είναι fine-tune του Laya, ενός πολύγλωσσου μοντέλου αποφάσεων, και το εκπαίδευσα στον υπολογιστή μου, με μια RTX 4080 SUPER, πάνω σε αληθινά λάθη του Whisper σε ελληνική και αγγλική ομιλία. Η σελίδα του στο Hugging Face έχει την περιγραφή του, τα δεδομένα και τα αποτελέσματα, και τα αρχεία που χρειάζεσαι για να το τρέξεις: το μοντέλο σε ONNX (343 MB), τον tokenizer και ένα αρχείο ρυθμίσεων. Τρέχει στον επεξεργαστή, χωρίς κάρτα γραφικών και χωρίς cloud, και είναι ανοιχτό με άδεια Apache 2.0.
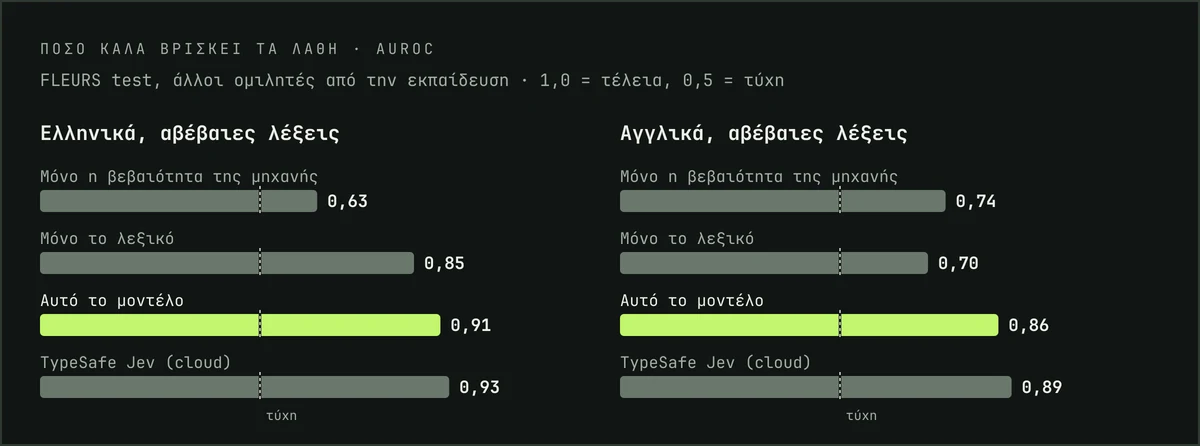
- Ελληνικά: AUROC 0,91 στις λέξεις όπου η μηχανή δεν είναι σίγουρη, εκεί που η βεβαιότητά της, μόνη της, φτάνει μόλις 0,63.
- Αγγλικά: 0,86 στις ίδιες λέξεις.
- Κοντά στο cloud: το Jev της TypeSafe, στο cloud, πιάνει 0,93 και 0,89. Το δικό μου είναι δωρεάν και τρέχει τοπικά.
Στην πορεία βρήκα και διόρθωσα τέσσερα προβλήματα στο ίδιο το RecMeets, από επαναλήψεις του Whisper μέχρι σιγανές φωνές που χάνονταν. Και το μοντέλο δεν έχει τελειώσει: συνεχίζω να το βελτιώνω.
Όλη η ιστορία, τα δεδομένα, η εκπαίδευση, ο υπολογιστής, οι αριθμοί και πως να το χρησιμοποιήσεις στα δικά σου έργα, είναι στη σελίδα του RecMeets' Laya.