 lefteros
29 Σεπτεμβρίου 2026 / Lefteris Iliadis / SomniusX
RecMeets' Laya: ποια λέξη ακούστηκε λάθος
29 Σεπτεμβρίου 2026
Το somniusx/recmeets-laya-words είναι ένα μοντέλο που εκπαίδευσα και δημοσίευσα στο Hugging Face. Απαντά σε μία ερώτηση: δεδομένης μιας λέξης μέσα στην πρότασή της, όπως την έγραψε μια μηχανή αναγνώρισης ομιλίας, πόσο πιθανό είναι να ακούστηκε λάθος; Δουλεύει στα ελληνικά και στα αγγλικά, χωράει σε 343 MB και τρέχει στον επεξεργαστή, χωρίς κάρτα γραφικών και χωρίς cloud. Είναι ανοιχτό (Apache 2.0), οπότε μπορεί να το χρησιμοποιήσει όποιος το χρειάζεται στα δικά του έργα, και συνεχίζω να το βελτιώνω.
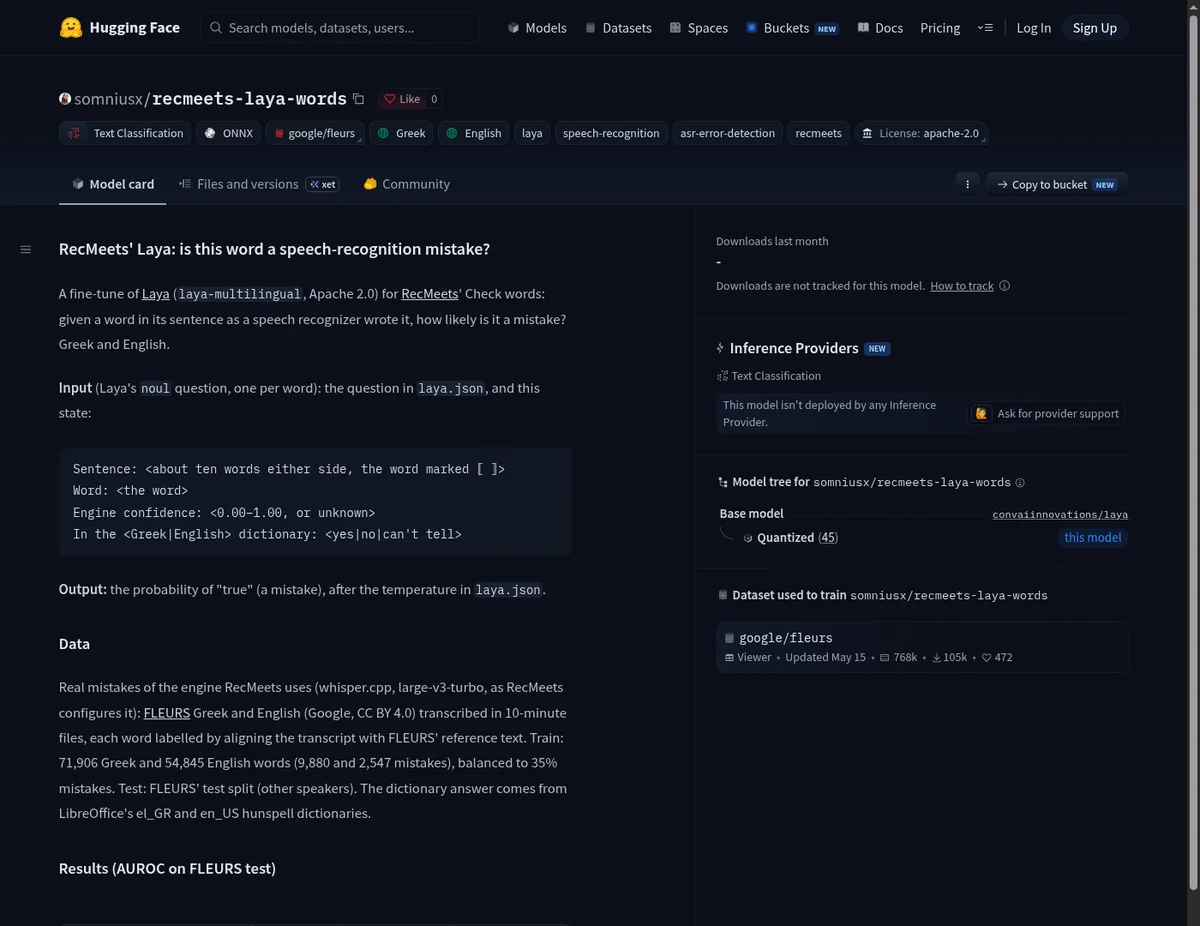 Είναι fine-tune του Laya (
laya-multilingual, Apache 2.0), ενός πολύγλωσσου μοντέλου αποφάσεων. Το έφτιαξα για τον Έλεγχο λέξεων του RecMeets, το βήμα που δείχνει ποιες λέξεις της απομαγνητοφώνησης μάλλον ακούστηκαν λάθος, για να τις ακούσεις και να τις διορθώσεις. Η σελίδα του στο Hugging Face έχει την περιγραφή, τα δεδομένα, τα αποτελέσματα και τα τρία αρχεία που χρειάζεσαι: το μοντέλο σε ONNX, τον tokenizer και ένα μικρό αρχείο ρυθμίσεων.
Γιατί χρειάστηκε
Μια μηχανή αναγνώρισης ομιλίας όπως το Whisper δίνει για κάθε λέξη και μια «βεβαιότητα». Στα ελληνικά όμως αυτή μόνη της ξεχωρίζει ελάχιστα τα λάθη: στις λέξεις όπου η μηχανή δεν είναι σίγουρη, μόλις 0,63 σε μια κλίμακα όπου το 0,5 είναι τύχη και το 1,0 τέλειο. Ένα ορθογραφικό λεξικό βοηθά, αλλά δεν πιάνει λέξεις που υπάρχουν αλλά είναι λάθος στο σημείο τους, όπως «είμαι» αντί για «είναι».
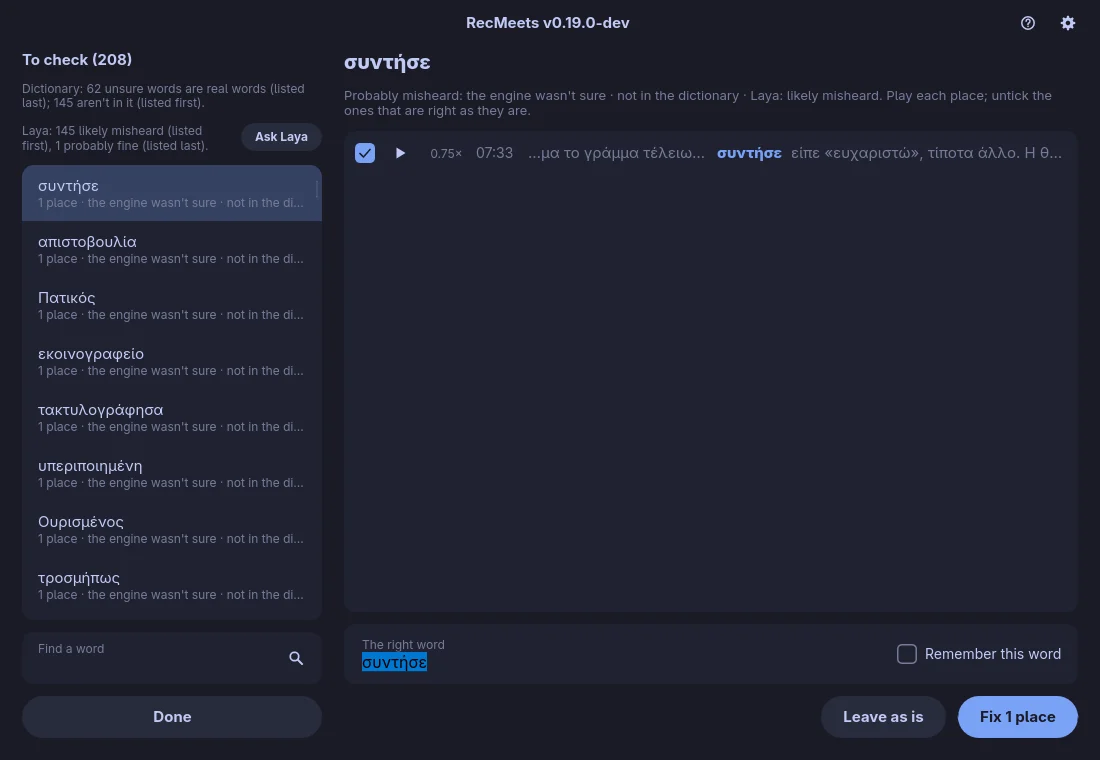 Χρειαζόταν λοιπόν κάτι που διαβάζει τη λέξη μέσα στην πρότασή της, ξέρει τι είπαν η μηχανή και το λεξικό, και δίνει μια ειλικρινή πιθανότητα. Το ζητούμενο ήταν να τρέχει στον υπολογιστή του χρήστη, γρήγορα, και να μη στέλνει τίποτα πουθενά, γιατί οι συσκέψεις είναι ιδιωτικές.
Υπάρχει και έτοιμη λύση στο cloud, το Jev της TypeSafe, με κλειδί και χρέωση ανά χρήση. Ο στόχος ήταν ένα τοπικό μοντέλο που να φτάνει κοντά του.
Το Laya με δύο λόγια
Το Laya δεν γράφει κείμενο όπως ένα chatbot. Του δίνεις μια κατάσταση (κείμενο ή JSON) και ερωτήσεις με τύπο (ναι/όχι, επιλογή, βαθμολογία), και σε ένα μόνο πέρασμα απαντά με βαθμονομημένες πιθανότητες, σε πάνω από 100 γλώσσες. Εκπαιδεύτηκε με ενισχυτική μάθηση πάνω σε αυστηρά σωστούς κανόνες βαθμολόγησης (RLCD), ώστε ο μόνος τρόπος να κερδίσει είναι να δηλώνει ειλικρινείς πιθανότητες. Επειδή δεν παράγει κείμενο, δεν έχει τίποτα να «φανταστεί».
Οι δημιουργοί του το λένε καθαρά: τα βασικά μοντέλα είναι κοντά στην τύχη χωρίς εκπαίδευση πάνω στην εργασία, και η αξία βρίσκεται στο fine-tuning. Το επιβεβαίωσα: σε δώδεκα ελληνικές λέξεις, έξι σωστές και έξι λάθος, καμία διατύπωση της ερώτησης δεν τις ξεχώρισε. Στο test σετ, το αρχικό laya-multilingual έπιασε 0,41, κάτω από την τύχη.
Τα δεδομένα: αληθινά λάθη, όχι εικασίες
Το μοντέλο μαθαίνει από αληθινά λάθη, αυτά που κάνει η ίδια η μηχανή που τρέχουν οι χρήστες του RecMeets:
- FLEURS της Google (CC BY 4.0): προτάσεις που διαβάστηκαν δυνατά, με ακριβές κείμενο αναφοράς, στα ελληνικά και στα αγγλικά.
- Τις απομαγνητοφώνησα με το ίδιο το RecMeets (whisper.cpp, μοντέλο large-v3-turbo, με τις ρυθμίσεις του RecMeets), ενώνοντας τις προτάσεις σε αρχεία των 10 λεπτών με 1,2 δευτερόλεπτα σιωπή ανάμεσα.
- Κάθε λέξη που έγραψε η μηχανή σημειώθηκε ως σωστή ή λάθος, με ευθυγράμμιση πάνω στο κείμενο αναφοράς.
- Η απάντηση του λεξικού για κάθε λέξη ήρθε από τα λεξικά hunspell του LibreOffice (el_GR, en_US).
- Εκπαίδευση: 71.906 ελληνικές και 54.845 αγγλικές λέξεις (9.880 και 2.547 λάθη), ισορροπημένες ώστε το 35% να είναι λάθη.
- Έλεγχος: το test σετ του FLEURS, με ομιλητές που το μοντέλο δεν άκουσε ποτέ στην εκπαίδευση.
Η ερώτηση που του κάνω
Για κάθε λέξη, το Laya παίρνει μια ερώτηση ναι/όχι (noul) και αυτή την κατάσταση:
Sentence: <περίπου δέκα λέξεις από κάθε πλευρά, με τη λέξη σημειωμένη ⟦ ⟧>
Word: <η λέξη>
Engine confidence: <0.00–1.00, ή unknown>
In the <Greek|English> dictionary: <yes|no|can't tell>
Απαντά με την πιθανότητα η λέξη να είναι λάθος, διορθωμένη με μια θερμοκρασία που μετρήθηκε σε ξεχωριστό κομμάτι των δεδομένων. Είναι επίτηδες απλό κείμενο, ώστε το RecMeets, που είναι γραμμένο σε Rust, να το χτίζει byte προς byte ίδιο με την Python του Laya.
Η εκπαίδευση
Ακολούθησα τη συνταγή του ίδιου του Laya: RLCD (policy gradient με ανταμοιβές από σωστούς κανόνες βαθμολόγησης) μαζί με soft cross-entropy, ένα κομμάτι των δεδομένων κρατημένο για τη βαθμονόμηση, και θερμοκρασία ανά τύπο ερώτησης στο τέλος. Όλα έτρεξαν τοπικά, σε container με PyTorch και CUDA, με όριο στη χρήση του επεξεργαστή ώστε ο υπολογιστής να μένει χρήσιμος. Μία εποχή κρατά περίπου 8 λεπτά.
| Εκτέλεση | Δεδομένα, εποχές | Ελληνικά, όλες οι λέξεις | Ελληνικά, αβέβαιες | Αγγλικά, αβέβαιες |
|---|---|---|---|---|
| 1 | ελληνικά, 3 (21 λεπτά) | 0,85 | 0,78 | |
| 2 | ελληνικά, 3, με το λεξικό στην είσοδο | 0,90 | 0,89 | |
| 3 | ελληνικά + αγγλικά, 4 | 0,88 | ||
| 4 (δημοσιευμένη) | ελληνικά + αγγλικά, 2 | 0,90 | 0,91 | 0,86 |
Η τρίτη εκτέλεση υπερπροσαρμόστηκε: στην τέταρτη εποχή η απώλειά της έπεσε κάτω από το μηδέν. Η τέταρτη, με δύο εποχές, είναι αυτή που δημοσίευσα.
Ο υπολογιστής
| Κάρτα γραφικών | NVIDIA GeForce RTX 4080 SUPER, 16 GB |
| Επεξεργαστής | AMD Ryzen 9 5950X, 16 πυρήνες / 32 νήματα |
| Μνήμη | 64 GB |
| Δίσκοι | Samsung 990 PRO NVMe, 2 TB και 1 TB |
| Μητρική | Gigabyte X570 AORUS ELITE |
| Σύστημα | Omarchy (Arch Linux με Hyprland) |
Η κάρτα γραφικών χρειάστηκε μόνο για την εκπαίδευση. Το έτοιμο μοντέλο τρέχει στον επεξεργαστή.
Τα αποτελέσματα
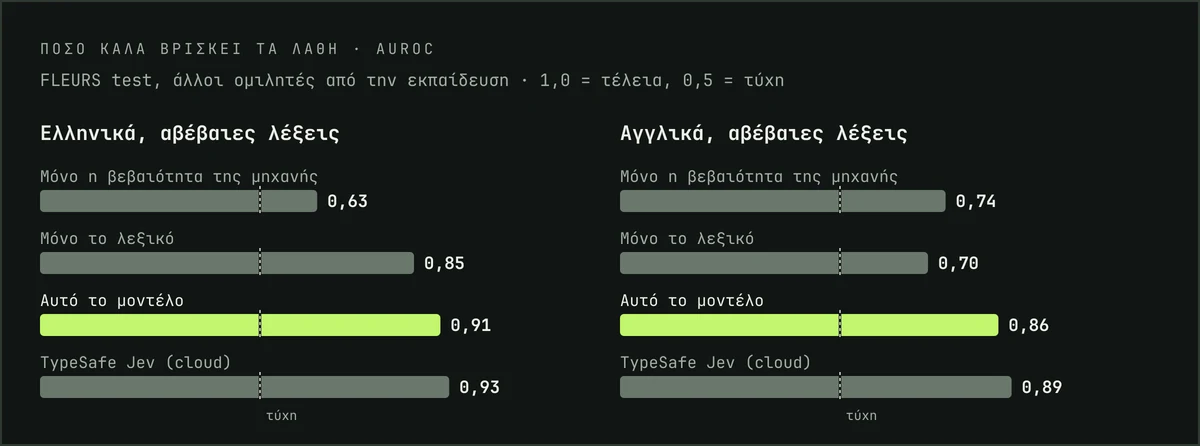
AUROC στο test σετ του FLEURS: 1,0 σημαίνει ότι κάθε λάθος βαθμολογείται πάνω από κάθε σωστή λέξη, 0,5 είναι τύχη. «Αβέβαιες» είναι οι λέξεις με βεβαιότητα της μηχανής κάτω από 0,5 και τουλάχιστον τέσσερα γράμματα, αυτές που δείχνει ο Έλεγχος λέξεων.
| Ελληνικά, όλες | Ελληνικά, αβέβαιες | Αγγλικά, αβέβαιες | |
|---|---|---|---|
| Μόνο η βεβαιότητα της μηχανής | 0,82 | 0,63 | 0,74 |
| Μόνο το λεξικό | 0,85 | 0,70 | |
| Το αρχικό laya-multilingual, ίδια ερώτηση | 0,41 | ||
| Αυτό το μοντέλο | 0,90 | 0,91 | 0,86 |
| TypeSafe Jev (cloud), ίδια είσοδος | 0,93 | 0,89 |
Στις λέξεις που μετράνε, το τοπικό μοντέλο φτάνει σε απόσταση αναπνοής από το Jev του cloud: δωρεάν, στον υπολογιστή σου, χωρίς να φεύγει τίποτα από αυτόν.
Μέγεθος και ταχύτητα
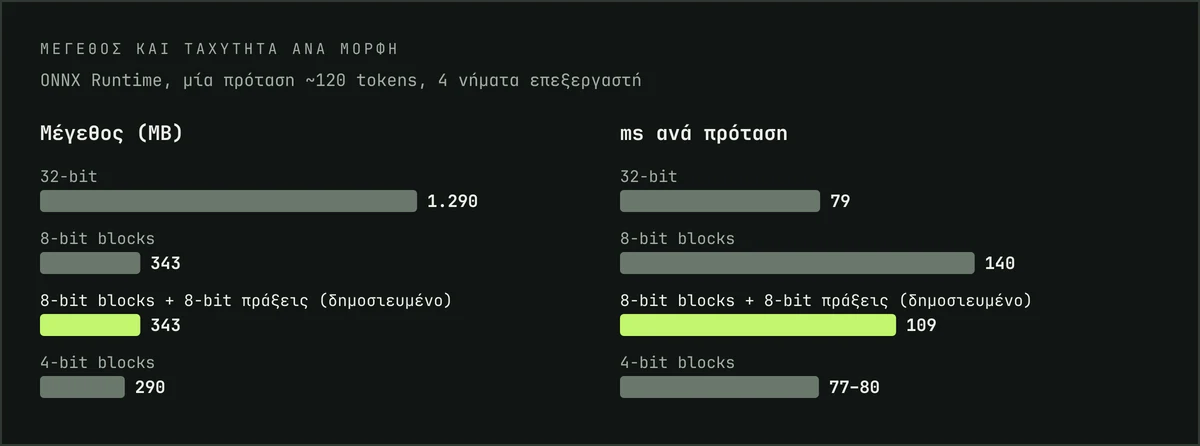
 Εξαγμένο σε ONNX, το μοντέλο βγαίνει 1,29 GB στα 32 bit, κυρίως από τον πίνακα embeddings του mmBERT με τα 256.000 tokens του. Εκεί υπήρχε μια παγίδα. Ο συνηθισμένος κβαντιστής 8 bit του ONNX Runtime, με κλίμακα ανά κανάλι, αυτός που χρησιμοποιεί το script του Laya, χάλασε το εκπαιδευμένο μοντέλο: έδινε την ίδια απάντηση σε κάθε πρόταση. Με κλίμακα ανά πίνακα έχανε περίπου 0,03.
Η λύση ήταν η μορφή μπλοκ 8 bit του ONNX Runtime (MatMulNBits, μπλοκ των 64) για τους πολλαπλασιασμούς πινάκων και 8 bit για τον πίνακα embeddings: 343 MB, με την ίδια ακρίβεια με τα 32 bit. Με αριθμητική 8 bit στον επεξεργαστή (accuracy_level 4), μια πρόταση θέλει περίπου 110 ms σε 4 νήματα, αντί για 140.
| Μορφή | Μέγεθος | ms ανά πρόταση | AUROC ελληνικά / αγγλικά |
|---|---|---|---|
| 32-bit | 1,29 GB | 79 | 0,905 / 0,859 |
| 8-bit blocks | 343 MB | 140 | 0,905 / 0,861 |
| 8-bit blocks, αριθμητική 8 bit (δημοσιευμένο) | 343 MB | 109 | 0,905 / 0,860 |
| 4-bit blocks | 290 MB | 77–80 | 0,889 / 0,854 |
Τα 32 bit είναι πιο γρήγορα, αλλά σχεδόν τετραπλάσια σε μέγεθος για κατέβασμα. Τα 4 bit είναι επίσης γρήγορα, αλλά χάνουν ακρίβεια. Κράτησα τη χρυσή τομή.
Μέσα στο RecMeets
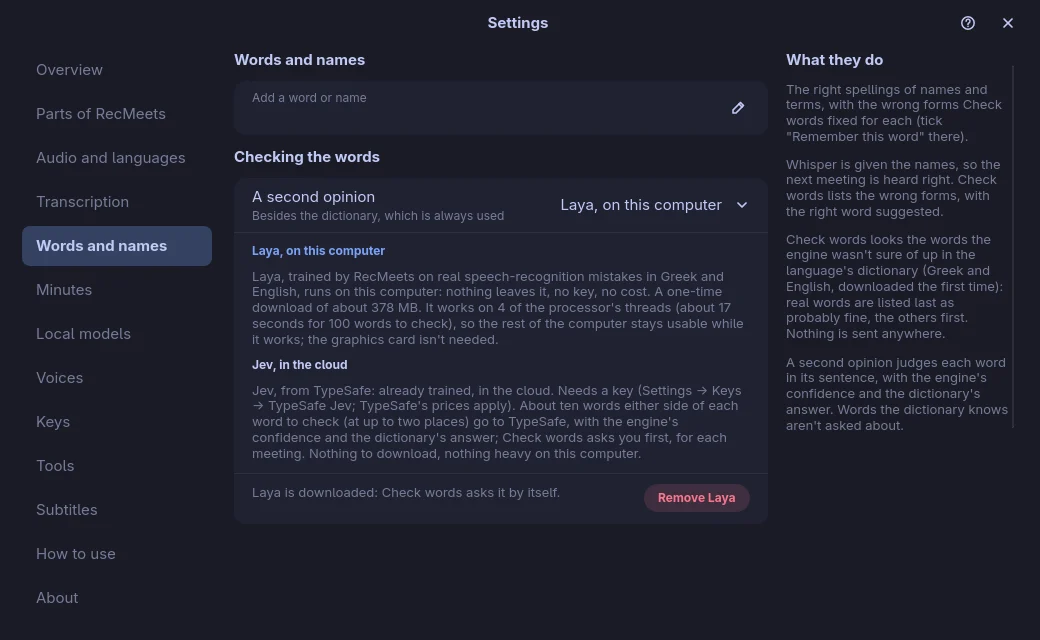 Το μοντέλο είναι ενσωματωμένο στο RecMeets, χωρίς Python και χωρίς εγκατάσταση. Κατεβαίνει μία φορά, 378 MB μαζί με τον tokenizer, κλειδωμένο σε συγκεκριμένη έκδοση και έλεγχο SHA-256. Το RecMeets χτίζει την είσοδο ακριβώς όπως η Python του Laya, και ένα τεστ τη συγκρίνει token προς token. Τρέχει μέσω ONNX Runtime σε 4 νήματα του επεξεργαστή, ώστε ο υπόλοιπος υπολογιστής να μένει ελεύθερος.
Για οικονομία χρόνου, όταν μια λέξη εμφανίζεται σε δύο σημεία, το δεύτερο ελέγχεται μόνο αν η πρώτη απάντηση είναι αβέβαιη (από 0,3 ως 0,7). Σε μια πραγματική ανάγνωση, 146 λέξεις ελέγχθηκαν σε 23,4 δευτερόλεπτα. Ο χρήστης μπορεί να διαλέξει και το Jev στο cloud, αν έχει κλειδί.
Τι διορθώθηκε στην πορεία
Για να φτιαχτούν τα δεδομένα, το RecMeets απομαγνητοφώνησε ώρες από διαβασμένες προτάσεις, και αυτό έδειξε τέσσερα προβλήματα στο ίδιο το RecMeets:
- Επαναλήψεις: η ίδια πρόταση γραμμένη 40 φορές στη σειρά, εκεί που είχαν διαβαστεί 30 διαφορετικές. Το Whisper συνεχίζει κάθε παράθυρο 30 δευτερολέπτων από το κείμενο του προηγούμενου, και μόλις ένα παράθυρο επαναληφθεί, το επόμενο συνεχίζει την επανάληψη.
- Προτάσεις που χάνονταν: όταν η ίδια πρόταση διαβαζόταν από δύο ανθρώπους στη σειρά, το Whisper παρέλειπε τη δεύτερη, ως «ήδη ειπωμένη».
- Σιγανές φωνές: κάποιες ηχογραφήσεις ήταν στα −62 dB, κάτω από το κατώφλι του ανιχνευτή ομιλίας, και δεν απομαγνητοφωνούνταν ποτέ.
- Ένα crash: ο χρονισμός λέξεων του whisper.cpp σταματούσε το πρόγραμμα όταν ένα παράθυρο προχωρούσε λίγα μόνο καρέ.
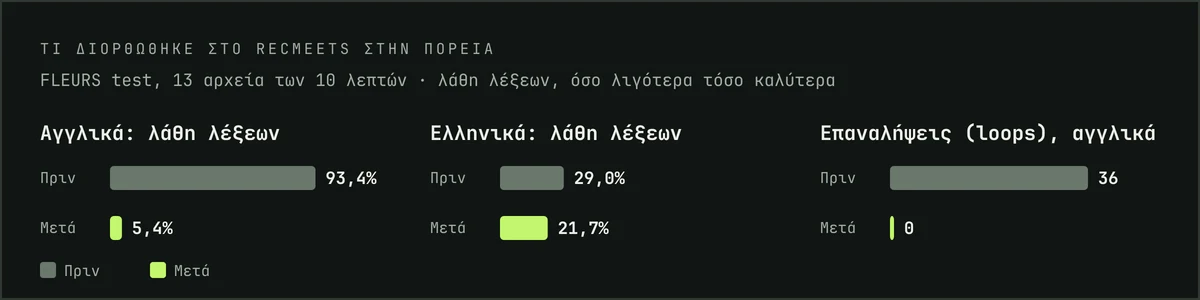
Με εξισορρόπηση της έντασης ανά παράθυρο και χωρίς το κείμενο του προηγούμενου παραθύρου, τα λάθη λέξεων στα αγγλικά έπεσαν από 93,4% σε 5,4%, στα ελληνικά από 29,0% σε 21,7%, και οι επαναλήψεις από 36 σε καμία. Οι ηχογραφήσεις με δύο κανάλια, όπως οι κλήσεις, κρατούν τα κανάλια τους χωρίς εξισορρόπηση, γιατί εκεί η ηχώ της άλλης πλευράς θα δυνάμωνε. Το crash διορθώθηκε με μία αλλαγή στη βιβλιοθήκη. Τα δεδομένα του Laya ξαναφτιάχτηκαν με τη διορθωμένη μηχανή, για να μαθαίνει από τα λάθη που βλέπουν οι χρήστες σήμερα.
Πως να το χρησιμοποιήσεις
Τα αρχεία είναι στο Hugging Face και δουλεύουν με το ONNX Runtime σε οποιαδήποτε γλώσσα:
model.onnx(343 MB): είσοδοιinput_ids,attention_mask,marker_pos,marker_mask,qtype(2), έξοδοςlogits. Μία πρόταση τη φορά.tokenizer.json: ο tokenizer του mmBERT, όπως είναι.laya.json: η ερώτηση, τα όρια των tokens, τα ειδικά tokens και η θερμοκρασία.
Χτίζεις την κατάσταση όπως παραπάνω, τρέχεις το μοντέλο και εφαρμόζεις τη θερμοκρασία στο αποτέλεσμα: αυτή είναι η πιθανότητα η λέξη να είναι λάθος. Ταιριάζει σε ό,τι βγάζει κείμενο από ομιλία, από υπότιτλους μέχρι σημειώσεις, όπου θέλεις να δείξεις στον χρήστη τι αξίζει να ελέγξει.
Τι ακολουθεί
Το μοντέλο δεν έχει τελειώσει. Οι επόμενες αποφάσεις του ίδιου τύπου που θα μπορούσαν να μοιραστούν το μοντέλο, με δικά τους δεδομένα:
- αν δύο σημεία των πρακτικών λένε το ίδιο πράγμα και μπορούν να ενωθούν,
- αν μια ημερομηνία, ένας αριθμός ή ένας υπεύθυνος στα πρακτικά στηρίζεται στις γραμμές της απομαγνητοφώνησης,
- αν οι υπότιτλοι δίπλα σε ένα εισαγόμενο αρχείο ανήκουν σε αυτό.
Όταν αλλάξει κάτι, θα ενημερώνεται αυτή η σελίδα.
Άδειες και πηγές
- somniusx/recmeets-laya-words: το μοντέλο, Apache 2.0.
- convaiinnovations/laya: το βασικό μοντέλο, Apache 2.0.
- google/fleurs: τα δεδομένα ομιλίας, CC BY 4.0.
- Τα λεξικά hunspell του LibreOffice για τα ελληνικά και τα αγγλικά.
- RecMeets: η εφαρμογή για την οποία φτιάχτηκε.
Δημοσιεύτηκε στις 29 Σεπτεμβρίου 2026.